- In der ausgelieferten App steckten weder faiss noch torch noch mcp. Jede Suche antwortete mit 500. Der Build installiert jetzt das Projekt statt einer handgeschriebenen Paketliste.
- Das Embedding-Modell reist im Paket mit, sodass eine frische Installation nicht mehr still auf reine Stichwortsuche zurückfällt. Daher die Downloadgröße.
- Ein Selbsttest ohne Fenster indexiert, bettet ein und ruft ab, direkt gegen das gebaute Binary. Der Build verpackt nicht, wenn er fehlschlägt.
Claude vergisst alles. Das hier ist der Teil, der bleibt.
Ein Gedächtnis-Daemon, der auf deinem Rechner läuft und Claude zurückgibt, was er letzte Woche wusste, im letzten Projekt, im letzten Monat.
Das alles hast du am Montag schon erklärt.
Sitzung beendet.
Der Daemon hat es behalten.
Nichts davon wurde zweimal getippt.
pnpm, niemals npm. Builds nach F:, niemals C:.Hippocampus
Postgres-Funktionen brauchen SET search_path = 'public'.Kleinhirn
Nie aus einem dirty Arbeitsverzeichnis nach prod deployen.Basalganglien
Secrets kommen per printf rein. echo hängt ein Newline an.Amygdala
Eine Änderung, ein PR. Der Review läuft vor dem PR.Präfrontaler Cortex
Ein Gehirn, auf deinem Rechner.
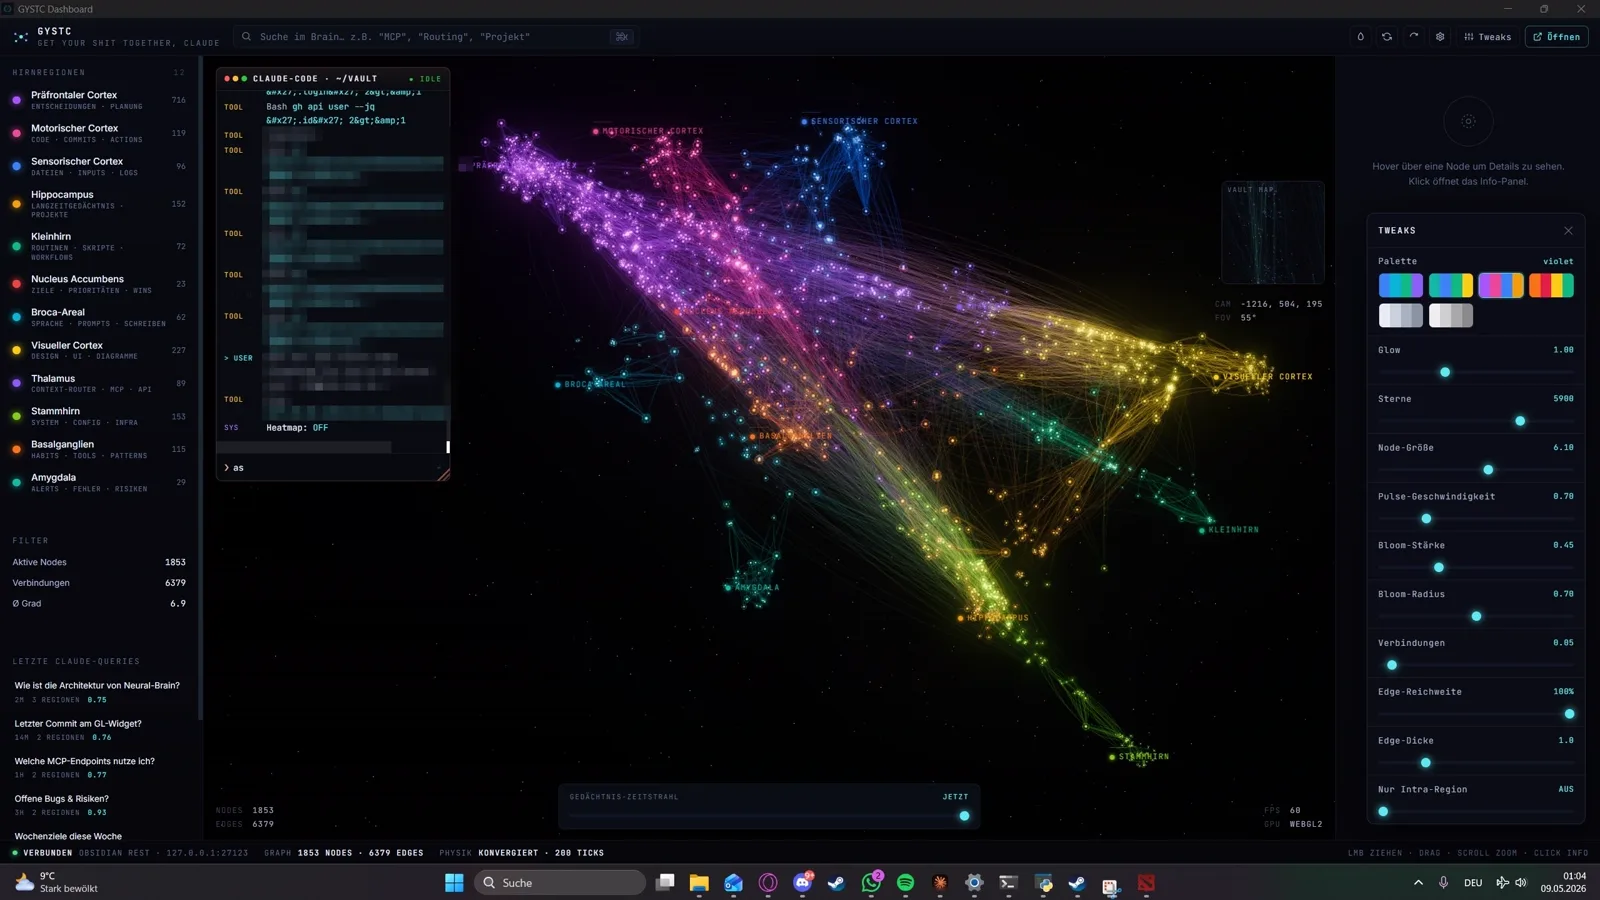
Jede Notiz landet in einer von zwölf Regionen. Die Region entscheidet, wo zuerst gesucht wird.
Zwei Spuren. Eine Antwort.
Früher startete jedes Fenster sein eigenes Gehirn.
Öffne die CLI, die Desktop-App und einen Agenten, und du hast das Embedding-Modell dreimal bezahlt, mit einem Kaltstart bei jedem.
Gleicher Prompt. Anderes Gedächtnis.
Du hast deine Projektstruktur fünfzig Mal erklärt. Er vergisst deine Architektur-Entscheidungen und kennt deine Konventionen nicht, also fängt jede Sitzung wieder bei null an, genau dann, wenn es nützlich wurde.
lass uns am Auth-Refactor weitermachen.
Klar. Kurze Frage: Kannst du mir die Projektstruktur nochmal erklären? Welche Auth-Bibliothek benutzt ihr? Wo liegen die Tokens?
......
lass uns am Auth-Refactor weitermachen.
Nach deinen Architektur-Entscheidungen vom März benutzt ihr Session-Cookies, kein JWT, und der Helfer liegt in lib/auth/session.ts. Soll ich die Rotationslogik erweitern, die wir letzten Dienstag skizziert haben?
Claude wählt sie selbst.
Notizen werden nach Funktion klassifiziert, nicht nach Ordner: Architektur geht in den Präfrontalen Cortex, Endpunkte in den Motorischen Cortex, Konfiguration ins Stammhirn. Eine Suche zielt auf die Regionen, die die Antwort plausibel enthalten können, statt alles zu durchkämmen, was du je geschrieben hast. Sechzehn Werkzeuge wurden in v1.1.0 auf acht zusammengelegt, weil weniger Auswahl die Auswahl besser machte.
Semantische Suche, Stichwortsuche und Graph-Traversierung in einem Aufruf. Fällt auf reine Stichwortsuche zurück, solange das Modell lädt, und blockiert daher nie.
Speichert eine Notiz. Eingebettet, in eine Region einsortiert, gegen den alten Inhalt versioniert und indexiert, alles im selben Aufruf.
Erkundet von einer Notiz aus über Rückverweise und Ähnlichkeit, um zu finden, wonach du nicht gesucht hättest.
Kürzlich geänderte Notizen, neueste zuerst. Braucht kein Modell und antwortet daher auch im Kaltstart sofort.
Anzahl Notizen, Anzahl Vektoren, Modellzustand, Regionsverteilung und die Warnflags. Immer sofort.
Listet die zwölf Regionen mit Anzahl und Beschreibung, oder passt Name, Farbe und Zuständigkeit einer Region an.
Sortiert Notizen über Stichwortregeln in Regionen, ganz ohne API-Schlüssel. Einzelne Notiz, Stapellauf, oder eine Korrektur, die den Klassifizierer lernt.
Verlauf, Vergleich oder Zurücksetzen. Bis zu fünfzig Versionen je Notiz, entdoppelt über den Inhalts-Hash.
Der ganze Stack, auf einer Maschine.
Das Dashboard ist dabei.
Dein Vault als kräftegerichteter Graph in Three.js. Knoten sind Notizen, Kanten sind Rückverweise, die Farbe ist die Region. Ein Klick öffnet die Notiz in Obsidian.
Claudes Werkzeugaufrufe laufen über einen PostToolUse-Hook ins Aktivitätsfenster, sodass eine Gedächtnis-Operation ihren Knoten aufleuchten lässt, während sie passiert.
Als Binary verpackt, das seine eigene Laufzeitumgebung mitbringt. Separat nur nötig, wenn du aus dem Quellcode baust.
L2-normalisierter Kosinus. Ein Schreiber hält eine Dateisperre; Leser bleiben durchsuchbar und werden befördert, wenn er endet.
BM25 mit eigenem Tokenizer, WAL-Modus, bei jedem Schreibvorgang neu aufgebaut.
In einem Hintergrund-Thread aus einem Modell im Paket geladen. Das Offline-Flag wird vor dem ersten Import gesetzt.
Ein dünner Proxy leitet in den geteilten Daemon weiter und startet ihn neu, wenn er mitten in der Sitzung stirbt.
Nur Loopback, Bearer-Token pro Lauf, Origin-Positivliste, Rumpf auf 8 MB begrenzt, Abschaltung nach dreißig Minuten Leerlauf.
Drei Schritte. Kein Konto, keine Cloud.
Windows 10 oder neuer, oder macOS 12 oder neuer. Claude Desktop oder Claude Code. Ein Ordner mit Markdown-Dateien, oder ein Obsidian-Vault, dessen Änderungen live übernommen werden.
Installieren
Führe die Datei aus oder öffne das DMG. Der Assistent trägt den MCP-Server bei Claude ein. Kein Paketmanager, kein PATH-Gefummel.
./GYSTC Dashboard.exe
Auf den Vault zeigen
Ein Feld: der Ordner, an den Claude sich erinnern soll. Markdown, Code, Notizen, alles Textuelle.
vault_path = "D:/notes/work"
Und vergessen
Jede Sitzung beginnt mit deinem Git-Kontext und den passenden Notizen. Du hörst auf, dich zu wiederholen.
{ "gystc": { "command": "gystc", "args": ["mcp"] } }
Zwölf Releases, die sein Verhalten verändert haben.
- Die Statistik zu lesen konnte den Vektor-Index löschen: zwei reine Anzeige-Aufrufer gaben eine fest verdrahtete Dimension an einen Loader, der bei Abweichung löscht.
- Die Dashboard-API liegt jetzt hinter derselben Token-Prüfung wie alles andere.
- Die CI wurde zu Lint plus Tests auf Windows und macOS, und der Build hängt daran.
- Dreiundvierzig Befunde geschlossen, über Lebenszyklus, Index-Integrität, Kuratierung, Daemon und Dashboard. Jeder zuerst gegnerisch bestätigt, jeder Fix durch einen Regressionstest festgenagelt.
- Ein fehlgeschlagenes Einbetten kann eine Notiz nicht mehr auf den Vektor ihres alten Inhalts zeigen lassen.
- Neue Vault-Kuratierung: über git rücknehmbares Aufräumen, Suche nach toten Links, Erkennung von Beinah-Dubletten, Anwenden nur nach menschlicher Freigabe mit Diff-Vorschau.
- Der Daemon beendet sich nach dreißig Minuten Stille selbst und gibt das Modell aus dem RAM frei. Der Proxy startet ihn beim nächsten Aufruf neu.
- Anfragerumpf auf 8 MB begrenzt, damit ein Token-Inhaber den Speicher nicht erschöpfen kann.
- Obergrenzen für netzseitige Abhängigkeiten gegen stille Major-Upgrades.
- Alle Clients teilen sich jetzt einen langlebigen Daemon, der Modell und Index ein einziges Mal lädt, statt dass jeder seinen eigenen Server startet.
- Das Servieren wurde zu einem dünnen stdio-zu-HTTP-Proxy, der den Daemon selbst startet und den Client nie hängen lässt.
- Nur Loopback, Bearer-Token pro Lauf, Origin-Positivliste, gehaltener kurzlebiger Port, damit es kein Wettrennen um den Token gibt.
- Der Start brachte früher jeden anderen GYSTC-Prozess um. Dieser globale Killer ist weg, und mit ihm die zufälligen Verbindungsabbrüche.
- Ein Server beendet sich selbst, wenn sein Client geht, statt als Waise die Datenbank festzuhalten.
- Eine Ein-Schreiber-Dateisperre verhindert, dass gleichzeitige Schreiber den Index beschädigen.
- Claudes Werkzeugaufrufe laufen ins Dashboard und lassen den passenden Hirnknoten in Echtzeit aufleuchten.
- Der Assistent schreibt jetzt das verschachtelte Hook-Schema von Claude Code, sodass die Hooks bei der Installation tatsächlich auslösen. Das alte flache Format wurde still ignoriert.
- Die erste Suche einer Sitzung friert nicht mehr ein: Die Abfrage fällt sofort auf Stichwortsuche zurück, statt auf das Modell zu warten.
- Der SessionStart-Hook zeigte auf ein Modul, das es nicht gab. Der Auto-Kontext war in jeder Installation still kaputt.
- Eine Notiz zu bearbeiten frischt ihre Chunk-Vektoren auf, sodass die Suche keine veralteten Ausschnitte mehr liefert.
- Alle acht Werkzeuge wurden vollständig asynchron mit dreißig Sekunden Zeitlimit. Die Event-Loop zu blockieren wurde unmöglich.
- Der Index speichert alle sechzig Sekunden und überlebt daher einen Prozessabbruch.
- SQLite-Busy-Timeout und WAL-Autocheckpoint beseitigten die Sperrfehler bei gleichzeitigem Zugriff.
- Das Warten auf Bereitschaft wanderte von der Event-Loop in einen Executor-Thread. Das war die Ursache jedes MCP-Hängers.
- Das Überspringen der Cache-Prüfung beim Start verkürzte das Laden des Modells von etwa elf auf sechseinhalb Sekunden.
- Kontext ging in retrieve auf; Verlauf, Vergleich und Zurücksetzen gingen in versions auf; drei Klassifizier-Werkzeuge wurden eins.
- Die Cross-Encoder-Nachsortierung ist seitdem standardmäßig aus.
- Die Anweisungen wurden neu geschrieben, mit ausdrücklichem Hinweis, wann nicht zu suchen ist. Das beendete Claudes Endlosschleifen.
- Builds für Windows und macOS, ein Assistent mit Vault-Auswahl und Ein-Klick-Installation von MCP und Hooks.
- Hybride Suche mit Reciprocal Rank Fusion, intelligentes Zerlegen, inhaltsadressierte Versionierung.
- Schutz gegen Pfad-Traversierung und ein XSS-Fix im Dashboard, noch vor der Auslieferung.
Trotzdem beantwortet.
Gehen meine Daten irgendwohin?
Nein. Alles läuft auf deinem Rechner, und der Daemon lauscht nur auf 127.0.0.1. Kein Konto, keine Telemetrie. Diese Seite liefert ihre Schriften selbst mit und stellt daher ebenfalls keine Anfrage an Dritte.
Was kostet es?
Nichts. Das Binary und der komplette Quellcode sind kostenlos, ohne Bezahlschranke und ohne Testphase.
Worin unterscheidet sich das von Claudes eingebautem Gedächtnis?
Das eingebaute Gedächtnis ist eine kurze Zusammenfassung des Gesprächs. Das hier ist dein ganzer Vault: semantische und Volltextsuche über alles, was du geschrieben hast, versioniert, in zwölf Regionen geordnet, von jedem Client geteilt. Die Dateien bleiben deine, als schlichtes Markdown.
Warum ist der Download so groß?
Weil das Embedding-Modell darin steckt. Eine frühere Version ließ es weg, und die semantische Suche fiel bei jeder frischen Installation still auf Stichwortabgleich zurück. Es mitzuliefern ist der Preis dafür, offline zu funktionieren.
Wie schwer ist der Daemon?
Das Embedding-Modell ist der Preis, solange es geladen ist. Nach dreißig Minuten Stille schaltet sich der Daemon ab und gibt es frei; der nächste Aufruf startet ihn unbemerkt neu.
Und wenn es abstürzt?
Der Proxy startet den Daemon neu, und die Ein-Schreiber-Sperre hält den Index konsistent. Deine Notizen liegen ohnehin als schlichtes Markdown auf der Platte, es gibt also nichts zu verlieren.
Windows sagt, es sei unsigniert.
Ist es auch. Klick auf Weitere Informationen, dann Trotzdem ausführen. Wenn du lieber vorher prüfst, vergleiche den Hash des Downloads mit SHA256SUMS.txt aus demselben Release.
Funktioniert es auch mit anderem als Claude?
Mit jedem MCP-Client. Der Daemon ist ein Prozess, und Clients hängen sich daran. Nichts daran ist Claude-spezifisch außer dem Namen.
Kann ich den Code lesen?
Vollständig. Binary und Quellcode sind unter MIT öffentlich: lies ihn, bau ihn, betreib ihn selbst.
Entpacken, den Ordner GYSTC Dashboard öffnen, die Datei ausführen. Der Assistent übernimmt Vault-Auswahl, MCP-Installation und Hook-Registrierung.
Das Image öffnen und die App nach Programme ziehen. Beim ersten Start richtet der Assistent deinen Vault ein und trägt den MCP-Server ein.
Python 3.11 oder neuer. Paket installieren, Setup ausführen, deinen MCP-Client darauf zeigen lassen.

Du bist seit ein paar Minuten hier. Das ist alles davon.
Diese Liste hat die Seite in deinen eigenen Browser geschrieben, klassifiziert mit denselben zwölf Regionen, die der Daemon benutzt. Verschickt wurde nichts. Es ist eine kleine, absichtlich unspektakuläre Fassung dessen, was GYSTC den ganzen Tag für Claude tut.